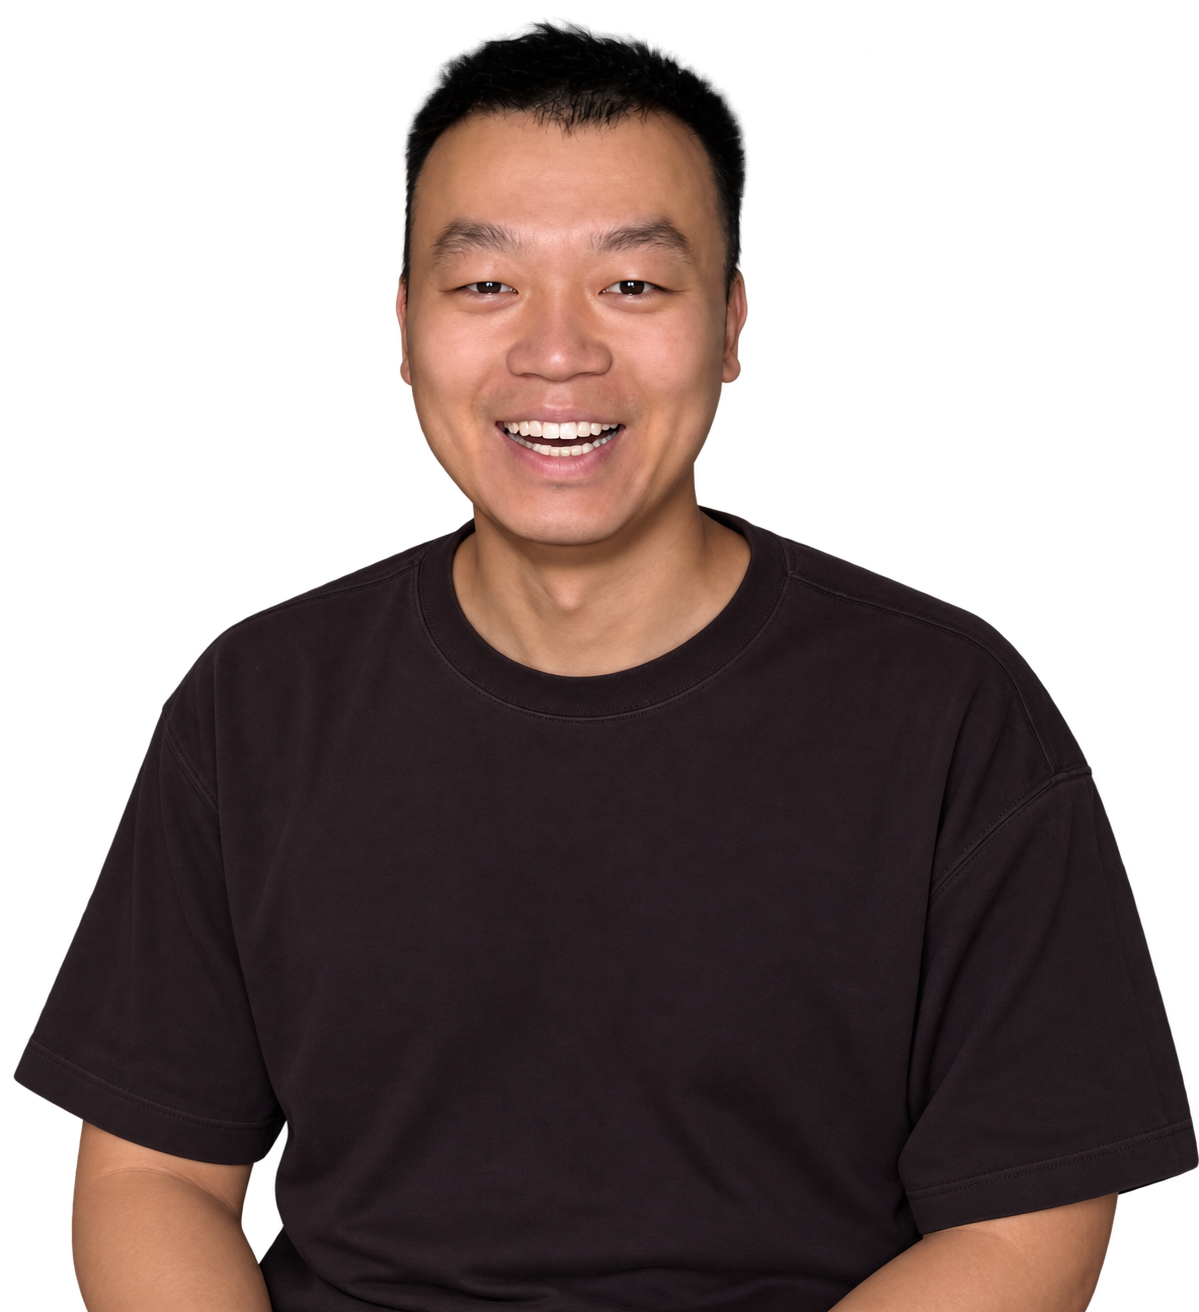
你好,我是卫卓 ✳

构建可靠的系统,
也创造有趣的产品。

运维开发 / SRE / 全栈开发
做过海量监控,也把产品和团队从 0 搭到 1。

卫卓
ALWAYS BUILDING
✳

曾在 字节跳动 / 好未来 / 猎豹移动

01A LITTLE ABOUT ME

工程思维,产品视角.

做过基础架构 SRE、游戏后台开发和全栈产品开发。

  • 稳定性工程:做过海量服务器、500+ 校区和 10 万+终端场景,持续优化采集、传输、存储与告警链路。
  • 故障协作:建设过告警路由、OnCall 与诊断 Agent,让多角色能一起认领、分析和推进故障。
  • 从 0 到 1:独立完成金融产品的 Web、iOS 与 Go 服务端,也曾从零组建游戏研发团队并担任主程。

比起先划定职责边界,我更习惯从问题出发,找到办法,再把它真正做出来。

大规模监控系统 端到端产品开发 OnCall 与 AI 故障协作
02SELECTED WORK

项目经历.

产品开发与监控平台实践,按时间由近到远。

OBSERVABILITY / AIEVERY SIGNAL MATTERS.
好未来 · 分布式监控与故障协作2023 — 2026

HermesMetrics

以预聚合等方式缓解 VictoriaMetrics 压力,并用 OnCall 与诊断 Agent 串联多角色故障协作。

10 万+学习机与多类型节点
VictoriaMetricsOnCallAI Agent
查看项目职责与成果
  • 基于好未来校区业务,设计整套 Metrics 监控系统,自研多个组件衔接开源 Exporter,覆盖 500+ 校区、1000+ 服务器、上万台网络设备及 10 万+学习机。
  • 随着接入规模扩大,围绕采集、传输和存储链路重新梳理数据流向,对部分指标在写入前进行预聚合,并结合多种数据收敛方式,降低 VictoriaMetrics 的写入、查询和存储压力。
  • 在保留关键监控能力的前提下,减少单个校区的监控资源消耗,让整套方案能够以更低成本继续扩展。
  • 基于 Alertmanager 建设告警路由和发送链路,并与内部通信工具打通响应、评论及处理进度;后续结合监控数据开发告警诊断 Agent,项目获好未来 AI 应用创新大赛二等奖。
  • 设计并开发 OnCall 协作系统,让研发、分校运维、技术支持、教学和教务等角色维护责任信息、认领告警并同步进度,同时为诊断 Agent 补充真实处置上下文。
PIXEL OCEAN / 2021 — 2023
像素海洋 · 技术负责人 / 主程2021 — 2023

游戏研发与技术团队建设

从零组建技术团队,同时担任主程,协调程序、建模、美术与策划把首款 Demo 做出来。

0 → 1技术团队与 Steam Demo
团队搭建主程开发跨职能协作
查看项目职责与成果
  • 加入早期团队后承担技术负责人和主程职责,从零搭建技术团队,负责人员招募、技术选型、开发计划及核心系统落地。
  • 团队早期资源有限,没有只做管理工作,而是持续作为主程参与一线开发,负责程序框架、游戏后台和核心功能实现,推动首款 Steam 游戏从想法走到可运行的 Demo。
  • 除程序开发外,还负责招募和协调建模、美术设计、策划等需要与技术紧密协作的岗位,处理不同专业之间的需求理解和开发衔接。
INFRASTRUCTURE AT SCALEBUILT FOR RELIABILITY.
字节跳动 · 基础监控平台2019 — 2021

VelaMetrics

面对原生 Open-Falcon 的性能边界,沿采集、传输、计算与存储链路持续探索和优化。

海量服务器秒级监控
Open-Falcon性能优化秒级监控
查看项目职责与成果
  • 参与字节跳动 VelaMetrics 基础监控平台建设,为公司海量服务器提供秒级基础监控。随着机器规模和指标量持续增长,原生 Open-Falcon 很快遇到性能上限,和团队一起围绕采集、传输、计算与存储链路逐段拆解瓶颈,持续改造核心组件。
  • 当时业内几乎没有同等规模的成熟方案,很多问题没有文档,也没有可以照搬的答案。只能结合真实流量不断定位、验证,在吞吐、延迟、资源消耗和故障影响之间反复取舍,把系统推到远超 Open-Falcon 原始设计边界的规模。
  • 参与头条春节等高流量项目保障,在业务峰值期间持续提供稳定的秒级机器监控,帮助业务和基础设施团队更快发现、定位问题。
  • 对接公司内部多套业务指标及监控系统,向各业务提供统一的机器基础监控数据,并在跨团队协作中持续完善平台的接入方式和稳定性。
OPEN SOURCE MONITORINGMONITOR. UNDERSTAND. IMPROVE.
猎豹移动 · 监控平台开发2018 — 2019

公司级服务器监控系统

在有限人力下深度改造 Open-Falcon,支撑公司级服务器监控、告警缓冲与平台自检。

5000+台服务器
Open-FalconDocker平台自监控
查看项目职责与成果
  • 在小团队配置下参与建设并长期维护覆盖猎豹全公司的服务器监控平台。基于 Open-Falcon 深度开发,以较少人力支撑线上 5000+ 台服务器的监控需求,单台 Transfer 的 QPS > 200。
  • 持续改造 Transfer、Gateway、Agent、Judge、Alarm 等核心组件;增加 Storage 模块处理 Docker 容器挂载服务树事件,并补充日志关键字监控能力。
  • 改造 Falcon-Sender 并增加队列机制,吸收告警高峰带来的瞬时流量,避免 SMS、邮件、企业微信和钉钉等外部发送接口被大量报警直接冲垮。
  • 独立完成 Falcon-Selfcheck 自检系统的前后端开发,让监控系统能够持续检查自身组件的运行状态,同时负责官方 GitHub 仓库的代码整理与对外展示。

好未来 AI 应用创新大赛 · 二等奖把监控数据、OnCall 认领和人工处置过程带进诊断链路,让 AI 参与分析、诊断与溯源。

AI × SRE
03THE JOURNEY

一路走来.

角色在变,对技术与创造的热爱一直没变。

荔枝可可科技图标荔枝可可科技全栈工程师(创业)2026.02 — 至今

从产品设计到工程实现,独立完成 TickPro 的 Web、iOS 客户端和 Go 服务端,开发账户连接、外部数据接入、持仓聚合、自动同步及行情展示等功能,将最初的产品想法做成可实际使用的金融应用。

查看相关项目
好未来校区监控小组技术负责人2023.09 — 2026.01

基于好未来校区业务,设计整套 Metrics 监控系统,自研多个组件衔接开源 Exporter,覆盖 500+ 校区、1000+ 服务器、上万台网络设备及 10 万+学习机。

查看相关项目
像素海洋图标像素海洋技术负责人 / 主程2021.10 — 2023.08

加入早期团队后承担技术负责人和主程职责,从零搭建技术团队,负责人员招募、技术选型、开发计划及核心系统落地。

查看相关项目
字节跳动Data-SYS SRE2019.05 — 2021.10

参与字节跳动 VelaMetrics 基础监控平台建设,为公司海量服务器提供秒级基础监控。随着机器规模和指标量持续增长,原生 Open-Falcon 很快遇到性能上限,和团队一起围绕采集、传输、计算与存储链路逐段拆解瓶颈,持续改造核心组件。

查看相关项目
猎豹移动监控运维开发2018.05 — 2019.05

在小团队配置下参与建设并长期维护覆盖猎豹全公司的服务器监控平台。基于 Open-Falcon 深度开发,以较少人力支撑线上 5000+ 台服务器的监控需求,单台 Transfer 的 QPS > 200。

查看相关项目
MV汇量科技运维开发实习生2017.09 — 2018.05

业务运维实习,开启基础设施与系统可靠性方向的职业实践。

南开大学滨海学院校徽
南开大学滨海学院

本科 · 计算机科学与技术

EDUCATION